
Что значит качество ИИ-агента?
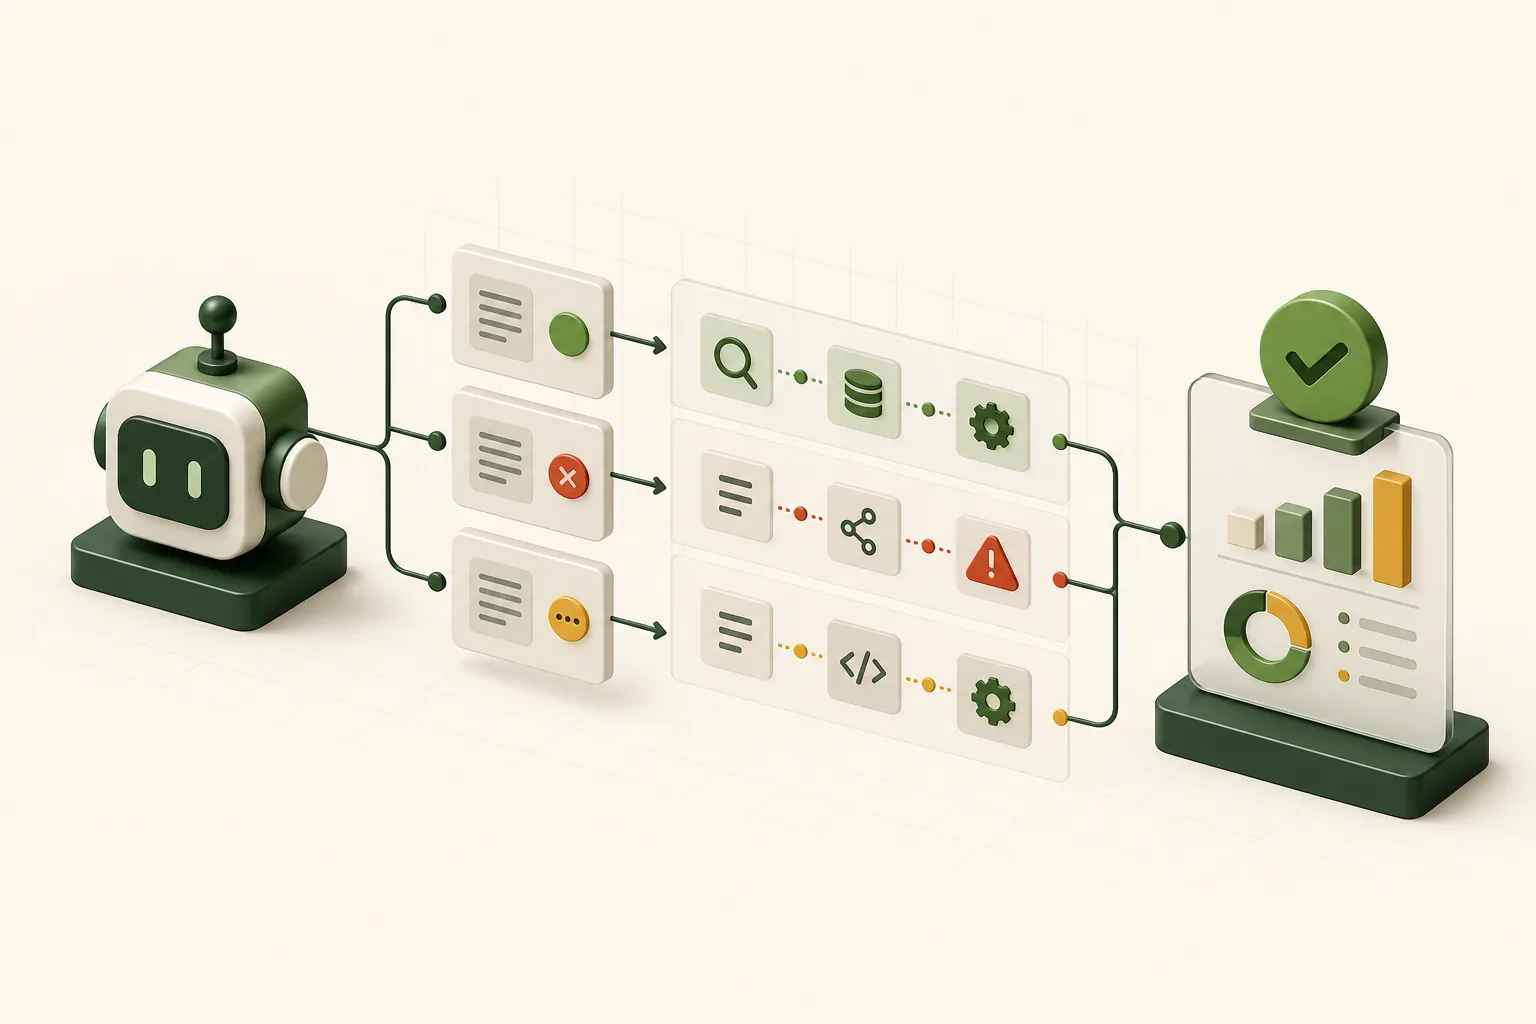
Качественный агент достигает цели на заданном классе задач, использует допустимые данные и tools, останавливается при нехватке информации и не выполняет запрещённых действий. Оценка должна включать результат и фактический trace. Один удачный разговор или средняя оценка текста не показывают надёжность всего процесса.
Как собрать набор eval cases?
Начните с реальных задач и разделите их на типичные, ошибочные, пограничные и чувствительные. Для каждого случая сохраните вход, контекст, ожидаемый результат, допустимые действия и причину отказа. Набор должен отражать будущую нагрузку, а не только примеры, на которых инструкция уже хорошо работает.
- Типичный успешный маршрут.
- Неполный или противоречивый вход.
- Ошибка инструмента или пустой источник.
- Запрос на запрещённое действие.
- Сложный, но допустимый пограничный случай.
Как измерять достижение задачи?
Для структурированного результата используйте детерминированные проверки полей и значений. Для черновика задайте рубрику с отдельными критериями и примерами. Метрика task success должна отражать принятие результата в процессе, а не субъективную симпатию проверяющего. Критичные ошибки считайте отдельно и не скрывайте средним баллом.
Зачем оценивать trace агента?
Финальный ответ может быть правильным после лишних или опасных шагов. Trace показывает выбранные tools, параметры, ответы, повторы, состояние и остановку. Проверяйте, использовал ли агент разрешённый источник, не передал ли лишние данные и запросил ли подтверждение перед значимой операцией. Это помогает найти причину, а не только зафиксировать сбой.
Какие метрики нужны для tools и безопасности?
Измеряйте правильность выбора инструмента и аргументов, долю успешных вызовов, ненужные повторы, обработку ошибок и соблюдение разрешений. Отдельный стоп-гейт нужен для отправки, удаления, оплаты, публикации и изменения прав. Нулевая критичная ошибка на маленьком наборе не доказывает абсолютную безопасность.
Как сравнивать версии агента?
Запускайте старую и новую версии на одном наборе и в сопоставимой среде. Фиксируйте модель, инструкции, tools, разрешения и лимиты. Смотрите не только на общий pass rate: новая версия может улучшить типовые задачи и ухудшить редкий критичный сценарий. Решение принимайте по заранее выбранным порогам и фактическим потерям.
Что измерять после запуска?
Собирайте task success, ручные исправления, отказы, задержку, стоимость принятой задачи, ошибки tools и срабатывания контрольных точек. Выборку из production превращайте в новые eval cases после удаления лишних персональных данных. Мониторинг не заменяет периодический повторный прогон полного набора после изменений.
Когда агент проходит приёмку?
Приёмка пройдена, когда агент достигает согласованного порога на типичных и сложных задачах, не нарушает критичные запреты, сохраняет достаточный trace и укладывается в бюджет процесса. Результат должен воспроизводиться несколькими прогонами. Для ограниченного пилота зафиксируйте дату, версии, владельца, известные ограничения и условие отката.
Экономику принятой задачи считайте по модели из статьи сколько стоит ИИ-агент.