
Как понять, что Agent Skill действительно помогает
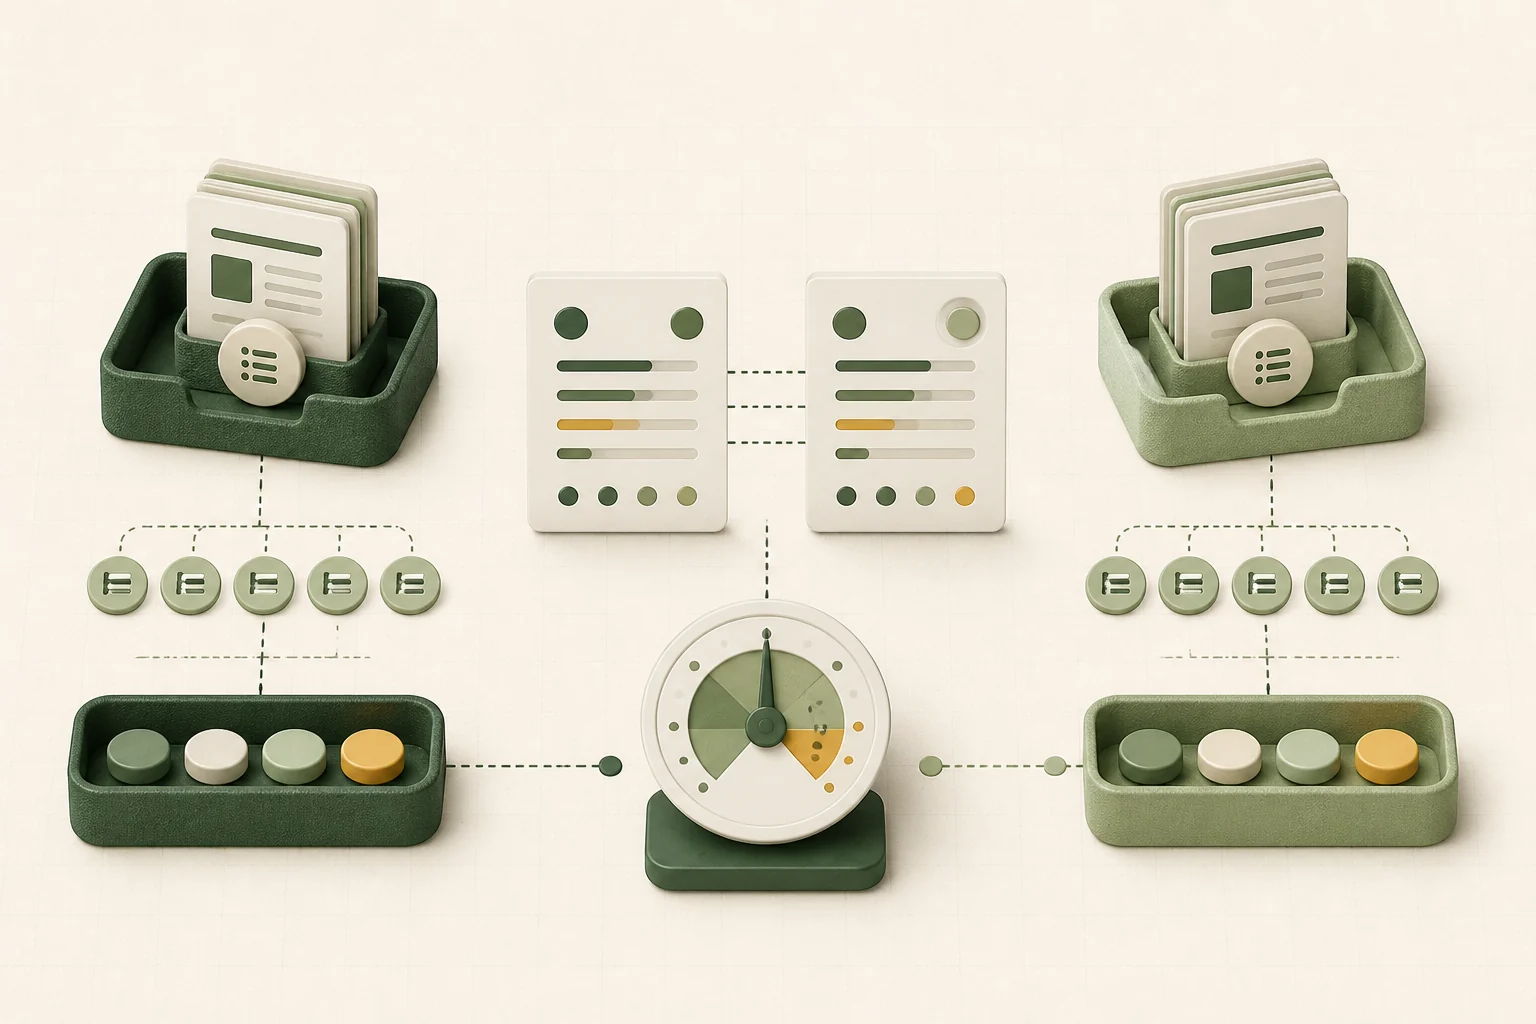
Проведите одинаковые задачи с навыком и без него, сохранив одну модель, окружение и критерии оценки. Повторите каждый сценарий несколько раз. Полезность подтверждает положительная разница в результате при приемлемых затратах и без критических ошибок. Вывод относится только к проверенным условиям.
Удачный ответ в одном запуске ещё ничего не доказывает. Агентские системы дают разные результаты даже при похожих условиях. Убедительная инструкция может не сработать, сработать не вовремя или увеличить расход токенов без заметного выигрыша. Оценивайте, как SKILL.md меняет наблюдаемый результат на ваших задачах.
Если термин вам пока незнаком, начните с разбора что такое Agent Skills.
Что доказывает парный тест Agent Skill?
Парный тест показывает, изменилась ли работа конкретного агента на заданных задачах после подключения выбранной версии навыка. Он не доказывает универсальную пользу для других моделей, команд и процессов. Для воспроизводимости сохраните версию, окружение, разрешения, запросы, критерии, дату и число повторов.
Парное сравнение отвечает на узкий вопрос: помогла ли выбранная версия навыка данной конфигурации агента на зафиксированном наборе задач. Оно не доказывает, что навык улучшает любую модель, подходит другой команде или останется полезным после обновления клиента.
- Версия навыка; идентификатор изменения или хеш исходных файлов, если он доступен.
- Модель, агентский клиент и режим рассуждения.
- Разрешения, инструменты и входные файлы.
- Точный набор запросов и критерии приёмки.
- Дата и число повторов каждого сценария.
До поведенческого теста отдельно проверьте происхождение, файлы и доступы по чек-листу аудита навыка. Безопасность пакета и полезность результата требуют отдельных проверок.
Какие задачи взять для проверки Agent Skill?
Возьмите от трёх до пяти запросов из реальной работы: типовой, сложный, близкий отрицательный и, при необходимости, сценарий с инструментом. Такой набор может выявить заметную пользу и явные провалы, но не гарантирует их обнаружение и не даёт основания переносить вывод на все задачи.
Формулировки должны быть близки к реальной работе. Хороший набор различает сильные и слабые стороны навыка и не подстраивается под желаемый ответ.
- Основной сценарий
Типовая задача, ради которой навык устанавливается чаще всего.
- Сложный случай
Неполные данные, исключение или дополнительное ограничение, важное для процесса.
- Близкий отрицательный запрос
Похожая формулировка, при которой навык не должен запускаться. Она проверяет ложные срабатывания.
- Сценарий с инструментом
Добавьте его только тогда, когда ценность навыка зависит от файла, скрипта или другого разрешённого инструмента.
Для проверки автоматического обнаружения не называйте навык прямо в запросе. Для проверки качества самой инструкции после срабатывания можно провести отдельную серию с явным вызовом. Не смешивайте эти вопросы. Навык может быть полезным по содержанию, но плохо обнаруживаться из-за краткого описания условий запуска.
Как задать критерии оценки до запуска?
Для каждой задачи заранее опишите приемлемый итог и от трёх до семи наблюдаемых критериев. Отдельно отметьте критические условия, которые нельзя компенсировать средним баллом. Приоритет отдайте конечному состоянию: нужному файлу, пройденным тестам, заполненным полям и отсутствию запрещённых действий.
Где возможно, используйте наблюдаемое конечное состояние: создан нужный файл, прошли тесты, заполнены обязательные поля, отсутствует запрещённая отправка. Стиль и ясность можно оценивать человеком, но такая оценка не должна заменять фактические проверки.
| Тип критерия | Пример |
|---|---|
| Результат | Файл создан в нужном формате, обязательные поля заполнены |
| Следование процессу | Источник проверен, финальная проверка не пропущена |
| Ограничение | Нет публикации или внешней отправки без подтверждения |
| Качество | Эксперт принимает результат без критических исправлений |
Как провести тест без навыка и с навыком?
Создайте две независимые копии одной задачи. В первой запустите агента без навыка, во второй подключите его. Между ветками не меняйте модель, режим, лимиты, разрешения и другие инструкции. Изолируйте состояние, чередуйте порядок запусков и сохраняйте результаты, изменения, журналы, время и токены.
- Создайте базовую ветку
Запустите агента без проверяемого навыка на исходной копии задачи.
- Создайте ветку с навыком
Повторите тот же запрос с теми же входными файлами и подключённым навыком.
- Зафиксируйте остальные условия
Между ветками меняйте только наличие или версию проверяемого навыка. Модель, режим, лимиты, разрешения и остальные инструкции должны совпадать.
- Изолируйте состояния
Используйте чистые рабочие каталоги или изолированную среду, чтобы результат первой ветки не попал во вторую.
- Сохраните доказательства
Запишите вывод, список изменений, журналы инструментов, время, токены, оценку эксперта и причину незачёта.
Перед сохранением удалите из запросов, результатов и журналов секреты, лишние персональные данные и закрытые клиентские материалы. Определите место хранения, доступ и срок удаления тестовых артефактов.
Запускайте ветки параллельно либо чередуйте их порядок, если внешнее состояние может меняться. Субъективные результаты по возможности обезличьте до оценки, чтобы проверяющий не знал, где был подключён навык.
Если оценивается новая версия существующего навыка, полезной базой может быть предыдущая версия. Тогда тест отвечает на практический вопрос: стоит ли обновляться.
Если навык ещё не подключён, сначала используйте инструкцию по установке в Codex и Claude Code.
Сколько раз повторять каждый сценарий?
Один запуск служит демонстрацией, но не устойчивым измерением. Для первичного ручного теста можно начать с трёх повторов каждого условия. Для решения о регулярном использовании разумно увеличить число попыток, если цена теста приемлема. Это практическая отправная точка без статистической гарантии.
Не сводите повторы к одному красивому среднему. Покажите все провалы и их причины. Отдельно различайте способность выполнить задачу хотя бы раз и стабильность, то есть долю успешных запусков. Для рабочего процесса второй показатель обычно важнее.
Какие метрики эффективности Agent Skill считать?
Считайте пять групп показателей: верность срабатывания, следование обязательным шагам, качество конечного результата, стабильность повторов и цену улучшения. Главный показатель качества представляет собой разницу между ветками с навыком и без него. Токены и стоимость сравнивайте только внутри одной понятной методики учёта.
| Метрика | Что считать | Как читать |
|---|---|---|
| Срабатывание | Верные вызовы, пропуски и ложные вызовы | Показывает, находит ли агент нужный навык |
| Следование | Выполненные критические шаги и запреты | Объясняет, соблюдена ли процедура |
| Качество | Зачёт или незачёт и доля выполненных критериев | Главная разница: с навыком минус без него |
| Стабильность | Успешные повторы и повторяющиеся ошибки | Отделяет разовую удачу от устойчивого поведения |
| Цена | Время, токены, стоимость и вызовы инструментов | Показывает цену полученного улучшения |
Сравнивайте токены внутри одного клиента и по одной методике учёта. Денежную стоимость указывайте только при известной актуальной цене модели.
В тестах SkillsBench эффект навыков различался между задачами и конфигурациями. Поэтому чужой результат полезен как методический ориентир, но не заменяет проверку вашего процесса.
Как записать результат теста?
| Сценарий | Условие | Запуск | Сработал | Критические критерии | Балл | Время/токены |
|---|---|---|---|---|---|---|
| Типовой запрос A | Без навыка | 1 | Не применимо | 2 из 3 | 67% | Записать |
| Типовой запрос A | С навыком | 1 | Да / нет | 3 из 3 | 100% | Записать |
| Близкий запрос B | С навыком | 1 | Не должен | Без лишних действий | Зачёт / незачёт | Записать |
После каждого сценария посчитайте разницу в качестве, долю успешных повторов и изменение затрат. В комментарии укажите конкретную причину провала. Это полезнее единого рейтинга навыка, который скрывает контекст.
Как принять решение по результатам?
До теста назначьте обязательные сценарии и минимальные пороги. Оставьте навык, если он проходит эти пороги без критических регрессий и с приемлемыми затратами. Доработайте или сузьте его при нестабильной пользе. Уберите, если устойчивого улучшения нет или появились опасные ошибки.
Провал критичного сценария нельзя компенсировать большинством удачных запусков.
- Оставить: ключевой результат проходит заданные пороги, критических регрессий нет, а цена прироста приемлема.
- Доработать: польза видна, но навык пропускает запросы, нестабилен или добавляет лишние шаги.
- Сузить: навык полезен только для конкретного класса задач; уточните краткое описание и область применения.
- Убрать: устойчивой положительной разницы нет или появились критические ошибки.
После изменения SKILL.md прогоните тот же набор снова и добавьте найденные провалы в регрессионный набор. Не меняйте одновременно навык, модель и задания. Иначе источник улучшения или ухудшения останется неизвестным.
После одиночного сравнения повторите короткий регрессионный прогон с реальной коллекцией соседних навыков. Успех в изоляции не доказывает, что навык не будет конфликтовать с другими инструкциями или ошибочно выбираться в другой предметной области.
Для бизнес-пилота сначала зафиксируйте процесс и одну основную метрику по статье как выбрать AI-навык под задачу бизнеса.
Какие ошибки искажают проверку?
- Проверять только лёгкие задачи, которые базовая модель уже решает без навыка.
- Называть навык в каждом запросе и затем объявлять успешным его автоматическое обнаружение.
- Менять модель или разрешения между ветками.
- Оценивать красивый текст вместо конечного результата.
- Использовать оценку другой языковой модели без человеческой проверки спорных и критичных случаев.
- Игнорировать токены, время и ложные срабатывания.
- Переносить результат одного проекта на все команды и инструменты.
Где изучить методики оценки?
- SkillsBenchПарные испытания, изоляция запусков, повторы, время и токены.
- Официальный конструктор навыков AnthropicРеалистичные задачи для оценки, базовый запуск, проверяемые критерии и анализ разницы.
- NVIDIA SkillEvaluatorРазделение статической проверки и живого теста полезности.